인공지능(AI) 기업이 도서 데이터를 확보하려면 출판사별 보유 콘텐츠와 저작권 계약 조건을 확인하는 과정이 필요하다. 출판업계는 도서 규모를 주로 권수로 파악하지만 AI기업은 데이터의 양을 토큰 단위로 계산한다는 점도 거래 과정의 어려움으로 꼽힌다. 도서 라이선싱 플랫폼 멘탯이 정식 계약된 도서 데이터를 AI 기업이 익숙한 기준으로 검색하고 계약할 수 있는 서비스를 선보였다.
도서 AI 라이선싱 플랫폼 멘탯(대표 전병욱)은 AI 기업용 도서 데이터 검색 서비스 ‘멘탯 디스커버리(Mentat Discovery Console)’를 출시했다. 멘탯은 출판사와 AI 기업을 연결해 도서 콘텐츠의 AI 학습 및 인용을 지원하는 기업이다. 2025년 설립 이후 국내 출판사 90여 곳과 라이선스 계약을 체결했으며, 계약 대상 도서는 약 3만4000종이다.
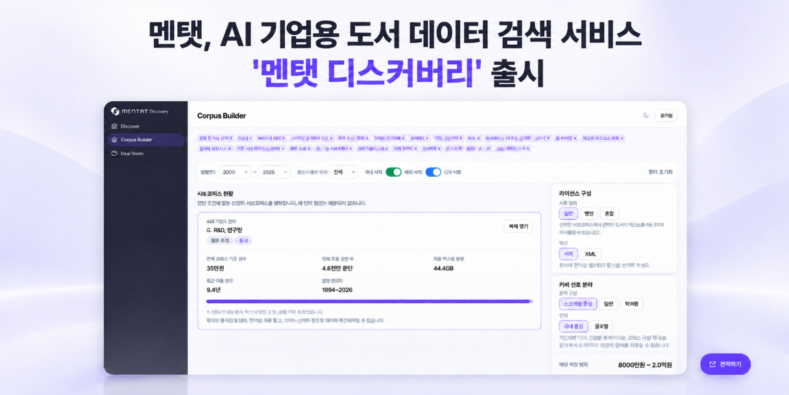
멘탯이 출시한 AI 기업용 도서 데이터 검색 서비스 ‘멘탯 디스커버리’ 화면. (자료 제공: 멘탯)
이번에 출시한 멘탯 디스커버리는 AI 기업이 필요한 도서 데이터를 검색하고 규모와 비용을 검토한 뒤 계약까지 진행할 수 있도록 구성한 서비스다. 검색 가능한 전체 도서 데이터 규모는 약 80억 토큰이다.
멘탯은 도서 데이터의 전처리와 메타데이터 생성을 거쳐 콘텐츠를 내용에 따라 분류했다. AI 기업은 카테고리별 도서 데이터를 검색하고 토큰 단위로 표시된 데이터 규모와 예상 비용을 확인할 수 있다.
기존에는 AI 기업이 필요한 도서를 확보하기 위해 출판사별 목록을 확인하고 개별적으로 협의해야 했다. 멘탯 디스커버리는 여러 출판사의 도서 정보를 통합해 검색할 수 있도록 하고, 데이터 규모를 토큰 기준으로 제공해 검토 과정을 간소화했다.
AI 학습 데이터셋·참조 API 제공…저작권 확인 부담 줄여
멘탯 디스커버리의 주요 기능은 내용 기반 카테고리 분류, 토큰 단위 데이터 규모 표시, 예상 비용 확인, 상세 카탈로그 요청 및 계약 연계다.
AI 기업은 필요한 데이터를 선택하고 예상 비용을 검토한 뒤 상세 도서 카탈로그를 요청할 수 있다. 이후 계약을 체결하면 활용 목적에 따라 학습 데이터셋 또는 참조·인용 API 형태로 데이터를 제공받는다.
학습 데이터셋에는 제목과 저자, 출판사, ISBN 등 서지 정보가 포함되며, AI 개발에 활용되는 JSONL 등의 파일 형식으로 제공된다.
참조·인용 API는 AI가 답변을 생성할 때 관련 도서의 문단을 검색하고 출처와 함께 제시할 수 있도록 지원한다. AI 모델 학습뿐 아니라 도서 콘텐츠를 참조하는 서비스에도 활용할 수 있는 구조다.
검색 대상은 모두 멘탯이 출판사와 정식 라이선스 계약을 체결한 도서다. AI 기업은 권리 관계가 확인된 데이터를 검토할 수 있어 콘텐츠 확보 과정에서 필요한 저작권 확인 부담을 줄일 수 있다.
전병욱 멘탯 대표는 “정식 라이선스 도서를 확보하는 것만큼 AI 기업이 필요한 책을 쉽게 찾고 바로 활용할 수 있게 하는 것이 중요하다”며 “멘탯 디스커버리는 출판사의 도서를 AI 기업에 익숙한 토큰과 비용 기준으로 보여줘 양측이 같은 기준에서 데이터를 검토할 수 있도록 만든 서비스”라고 말했다. 이어 “책이 AI에 더 많이 활용되고, 그에 따른 수익이 출판사와 저자에게 돌아가는 구조를 확대해 나갈 계획”이라고 덧붙였다.
멘탯 디스커버리는 멘탯 홈페이지의 ‘도서검색’ 메뉴와 서비스 웹사이트에서 이용할 수 있다.
The post 멘탯, AI 학습용 도서 3만4000종 검색 서비스 출시…80억 토큰 데이터 거래 지원 appeared first on 벤처스퀘어.